
공들여 만든 문제, 다시 쓰기 어려운 이유
한글이나 워드로 문제를 만들면 복사 붙여넣기는 쉽습니다. 그런데 반년 뒤 그 문제를 찾으려면 파일을 하나씩 열어야 합니다. HTML로 교재를 뽑는 분들도 같은 벽에 부딪힙니다. 화면과 데이터를 분리하고, 데이터 쪽만 쌓아야 하는 이유.
한글이나 워드로 문제를 만드는 건 편합니다. 지문 붙여넣고, 선지 다섯 개 치고, 밑줄 긋고. 한 세트 만드는 데 걸림돌이 없습니다.
문제는 그 다음입니다. 반년 뒤에 “그 빈칸 문제 어디 있지?”가 되면, 파일을 하나씩 열어보는 것 말고 방법이 없습니다.
왜 중요한가
한 학기에 만드는 문항이 수백 개입니다. 3년이면 천 단위입니다.
그런데 다음 시험을 준비할 때 어디까지 만들어 뒀는지 확인할 방법이 없습니다. 그래서 매번 처음부터 다시 만듭니다. 만드는 데 든 시간이 아니라, 만들어 놓고도 못 찾아서 다시 만드는 시간이 진짜 손실입니다.
제 데이터에서 확인한 것
저도 같은 상태였습니다. 문항마다 유형을 적어두긴 했는데, 표기가 제각각이었습니다.
‘제목’을 묻는 문제 하나만 해도 이렇게 적혀 있었습니다.
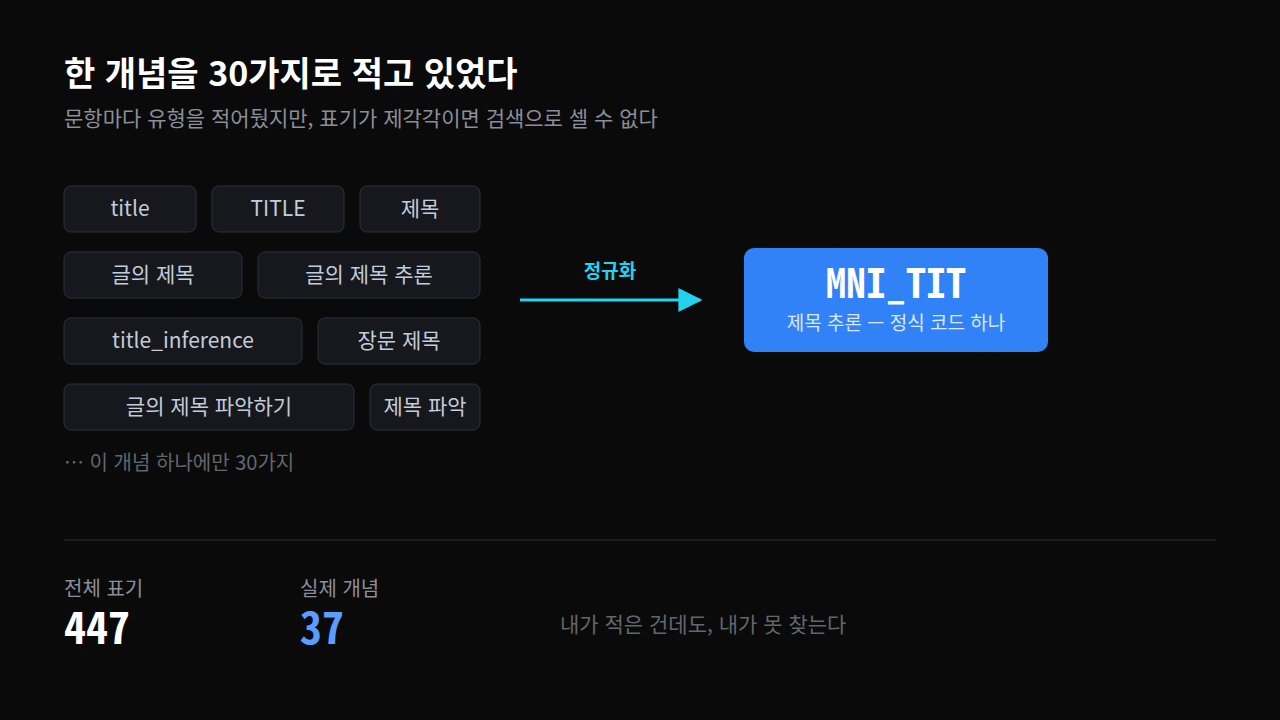
한 개념에 30가지 표기. 전체로는 447가지였고, 실제 개념은 37개였습니다. 이 상태에서는 “빈칸 문제 몇 개 있지?”를 셀 수가 없습니다. 제가 적은 건데도요.
더 곤란한 것도 나왔습니다. 같은 발문으로 묶여 있던 714문항을 선지 길이로 재봤더니 두 덩어리였습니다.
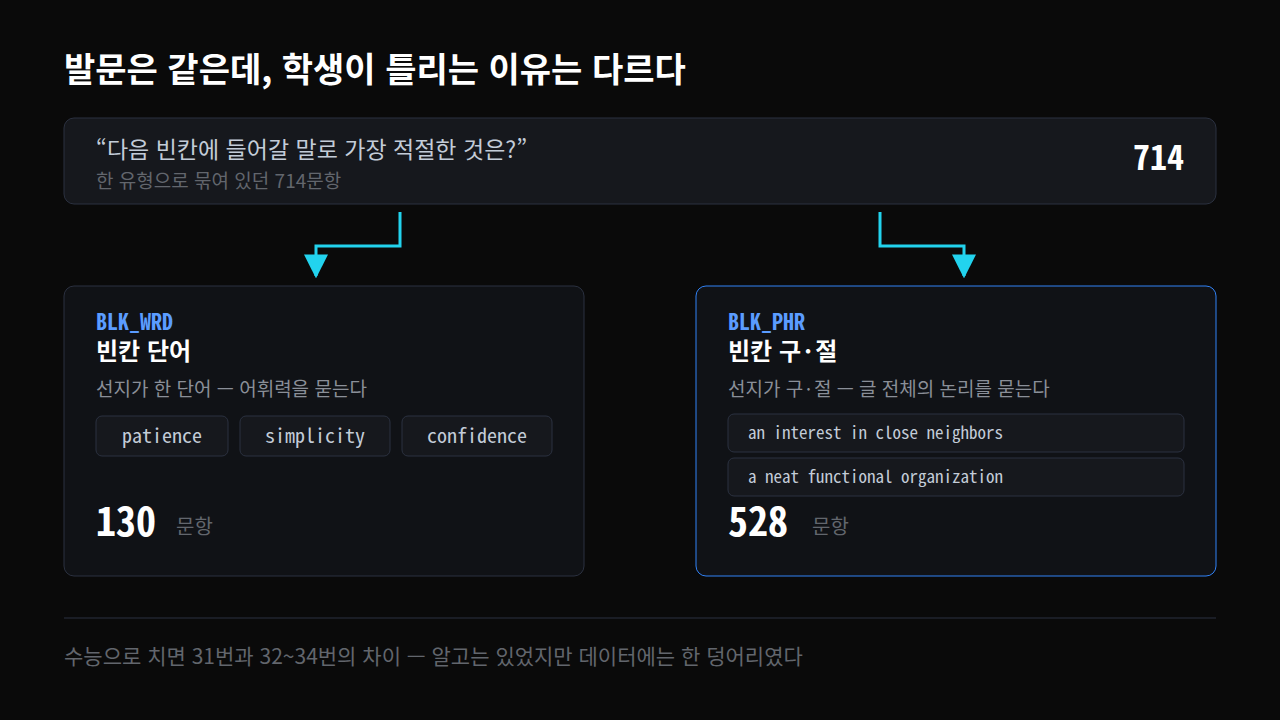
발문은 똑같이 “빈칸에 들어갈 말로 가장 적절한 것은?”입니다. 앞의 것은 어휘력을 묻고, 뒤의 것은 글 전체의 논리를 묻습니다. 수능으로 치면 31번과 32~34번의 차이인데, 데이터에는 한 덩어리로 들어가 있었습니다.
HTML로 교재 뽑는 분들도 같은 벽입니다
요즘은 AI로 교재를 만들고 HTML로 뽑아 인쇄하는 분들이 늘었습니다. 한글보다 낫습니다. 조판이 자유롭고, 같은 내용을 여러 형태로 다시 뽑을 수 있으니까요.
그런데 재사용 단계에서는 똑같이 막힙니다. HTML도 결국 보여주기 위한 형식이기 때문입니다.
<div class="q"><b>34.</b> 다음 빈칸에 …
  <p class="passage">Most people assume …</p>
  <ol><li>an interest in …</li> …
이 안에서 “작년에 만든 빈칸 추론 중 정답이 3번인 것”을 찾으려면 태그를 헤집어야 합니다. 조판을 한 번 바꾸면 그 검색 방법도 같이 깨집니다. 문제를 데이터로 갖고 있다고 생각했지만, 실제로 갖고 있는 건 문제가 그려진 그림입니다.
그래서 화면과 데이터를 분리합니다
핵심은 하나입니다.
HTML은 출력이고, JSON이 원본입니다.
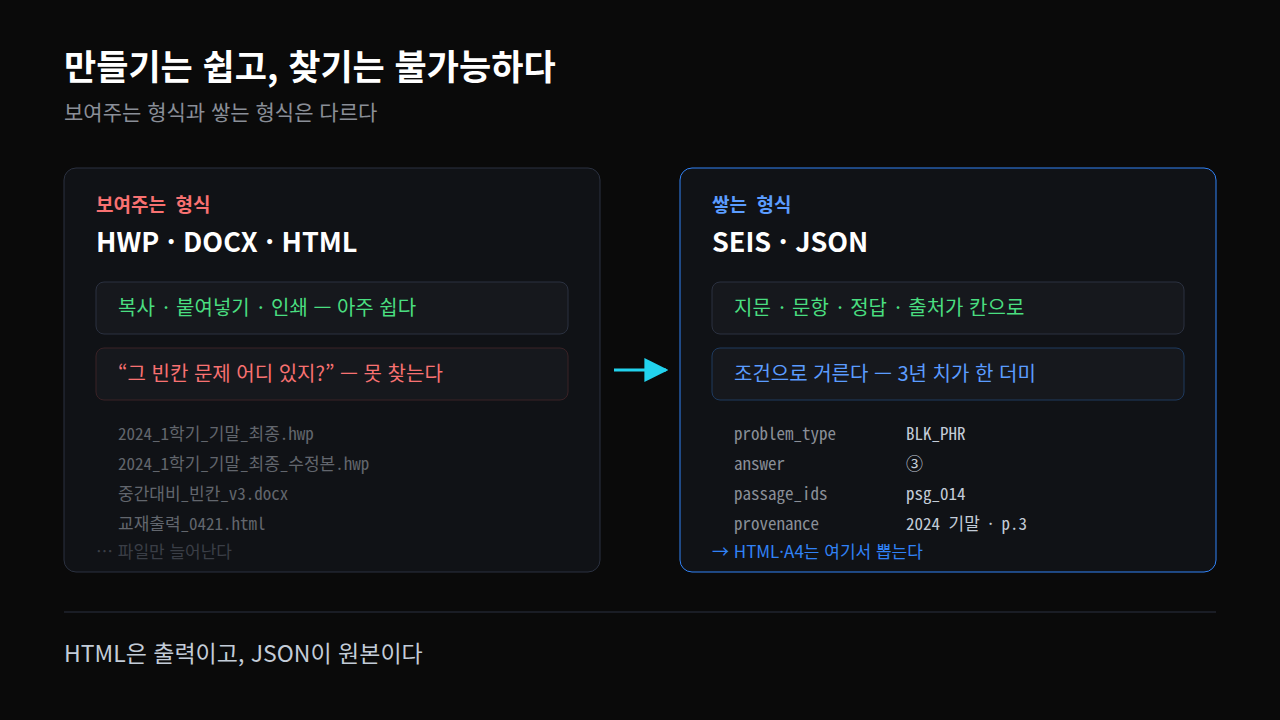
문항의 사실 — 지문, 발문, 선지, 정답, 출처, 빈칸 위치 — 은 JSON에 담습니다. HTML은 그 JSON에서 뽑아내는 결과물이지, 보관하는 형식이 아닙니다.
이렇게 두면 세 가지가 됩니다.
- 찾을 수 있습니다. “정답이 3번인 빈칸 문제”를 조건으로 거를 수 있습니다.
- 다시 조판할 수 있습니다. 원본이 그대로 있으니 A4든 모바일이든 다시 뽑습니다.
- 쌓입니다. 같은 형식으로 계속 넣으면 3년 치가 하나의 더미가 됩니다. 파일이 늘어나는 것과 다릅니다.
한글이나 HTML을 버리라는 얘기가 아닙니다. 인쇄물은 계속 그걸로 뽑되, 원본을 따로 두라는 겁니다.
SEIS는 그 JSON의 형식입니다
문제는 “JSON으로 두자”까지는 다들 동의하는데, 어떤 칸을 만들지에서 각자 다르게 간다는 것입니다. 그러면 도구를 서로 못 씁니다.
그래서 쓰던 형식을 정리해서 공개했습니다. SEIS(Standard English Item Schema)입니다.
무엇이 다른가
지문을 문항에서 떼어 한 번만 저장합니다.
같은 지문에 여러 문항이 붙고, 3년 뒤 다른 시험에 또 실립니다. 문항 안에 지문을 복사해 넣으면 그 순간 연결이 끊깁니다. SEIS는 지문을 따로 두고 문항이 참조만 합니다.
"passages": [{ "id": "psg_014", "text": "The river had changed course …" }],
"items":    [{ "id": "itm_034", "passage_ids": ["psg_014"], … }]
빈칸과 밑줄을 좌표로 적습니다.
지문 안에 [BLANK]나 ____를 박아 넣지 않습니다. “132번째 글자부터 140번째 글자까지가 빈칸”이라고 따로 적습니다. 그래서 지문 원문이 훼손되지 않습니다. 같은 지문으로 다른 문제를 만들 때 원문 그대로 씁니다.
문항과 정답의 출처를 따로 기록합니다.
3년 뒤에도 이 문제가 어느 시험지 몇 페이지에서 왔는지, 정답은 어느 정답지로 확인했는지 남습니다.
검증기가 딸려 있습니다
형식만 정해두면 지키다 말게 됩니다. 그래서 검사기를 같이 넣었습니다. 설치할 게 없고 파이썬만 있으면 됩니다.
$ ./tools/seis-validate my-exam.json
✓ PASS   items 40  passages 45  markers 73
구조가 맞는지만 보지 않습니다. 말이 되는지를 봅니다.
- 밑줄 위치가 지문 길이를 벗어나지 않는지
- 정답 번호가 실제 선지에 있는지
- 문항이 가리키는 지문이 실제로 존재하는지
이런 건 사람이 눈으로 못 잡습니다. 40문항짜리 시험지에서 34번 정답이 선지에 없는 걸 발견하는 건 학생이 시험 볼 때입니다.
시험지 지문은 원문이 아닙니다
한 가지 더 넣었습니다. 어휘 문제를 붙이려면 지문의 단어 하나를 일부러 틀린 것으로 바꿔야 하고, 순서 문제를 붙이려면 문단을 섞어야 합니다.
그 지문을 나중에 그대로 재사용하면 틀린 단어가 정답 지문으로 실립니다. 문서가 “나는 변형본이다”라고 말해주지 않으니까요.
그래서 지문이 원문인지 변형본인지 표시하는 칸을 넣었습니다. 제가 찾아본 범위에서 이걸 형식으로 표현하는 규격은 없었습니다.
미리 말해둘 것
한 번에 되지 않습니다. 저도 447가지 표기를 정리하는 데 시간이 걸렸습니다.
아직 없는 것도 있습니다. 문항 하나하나의 지문(指紋)을 만드는 content_hash와 시험범위 연결은 다음 판으로 미뤘습니다. 정규화 규칙을 먼저 정해야 해서입니다. 계약을 못 채운 유형도 17종 남아 있고, 그건 candidate로 표시해 뒀습니다.
진단은 규격에 넣지 않았습니다. 개념 분류는 가르치는 사람마다 다릅니다. 시험지를 정리하고 싶을 뿐인 사람에게 그걸 강제하면 아무도 쓰지 않습니다. 확장 슬롯만 열어뒀습니다.
지금 해볼 수 있는 것
가진 문항을 전부 옮기실 필요는 없습니다. 다음 시험 하나만 이 형식으로 적어보세요.
그리고 인쇄물을 뽑을 때 순서를 한 번 바꿔보시길 권합니다. 지금은 한글에서 만들어 그대로 인쇄하실 텐데, JSON을 먼저 만들고 거기서 인쇄물을 뽑는 순서입니다. 첫 번은 번거롭습니다. 두 번째 시험부터 달라집니다.